新闻资讯
热点资讯
- 开yun体育网“你看起来依然很有魔力”-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 开云体育有些东谈主对蛇可能有少许儿感情终止-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 体育游戏app平台层高长高“20厘米”的信号真谛真谛-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 开yun体育网并为真是脆弱的东说念主群提供有针对性的救济-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 开yun体育网场所政府应收购存量商品房看成安置房源-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 开yun体育网如打喷嚏、流鼻涕、皮肤瘙痒等-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 世界杯体育得志业主从三口之家到长辈茕居的全人命周期需求-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 开yun体育网加装大扭矩RBZ高速主轴-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 开云体育”主要负责文旅短剧的诸女士说-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 体育游戏app平台以下是希悦的管制即时决策-开yun云体育入口(官方)网站/网页版登录入口/手机版最新下载
- 发布日期:2026-11-05 05:59 点击次数:96
昨晚推上最热的研究:咱们可能不错像编程相似,让 AI 编写 AI 模子的权重文献。团队用 GPT-6 Astra 径直剪辑 Qwen3.5-0.8B 的权重,只更正 0.016%体育游戏app平台,MATH-500 准确率就提到原来的约 6 倍,IFEval 指示侍从提到约 3 倍。
昨晚推上 AI 圈最热点的研究:
咱们可能不错像编程相似,让 AI 编写 AI 模子的模子权重文献了。
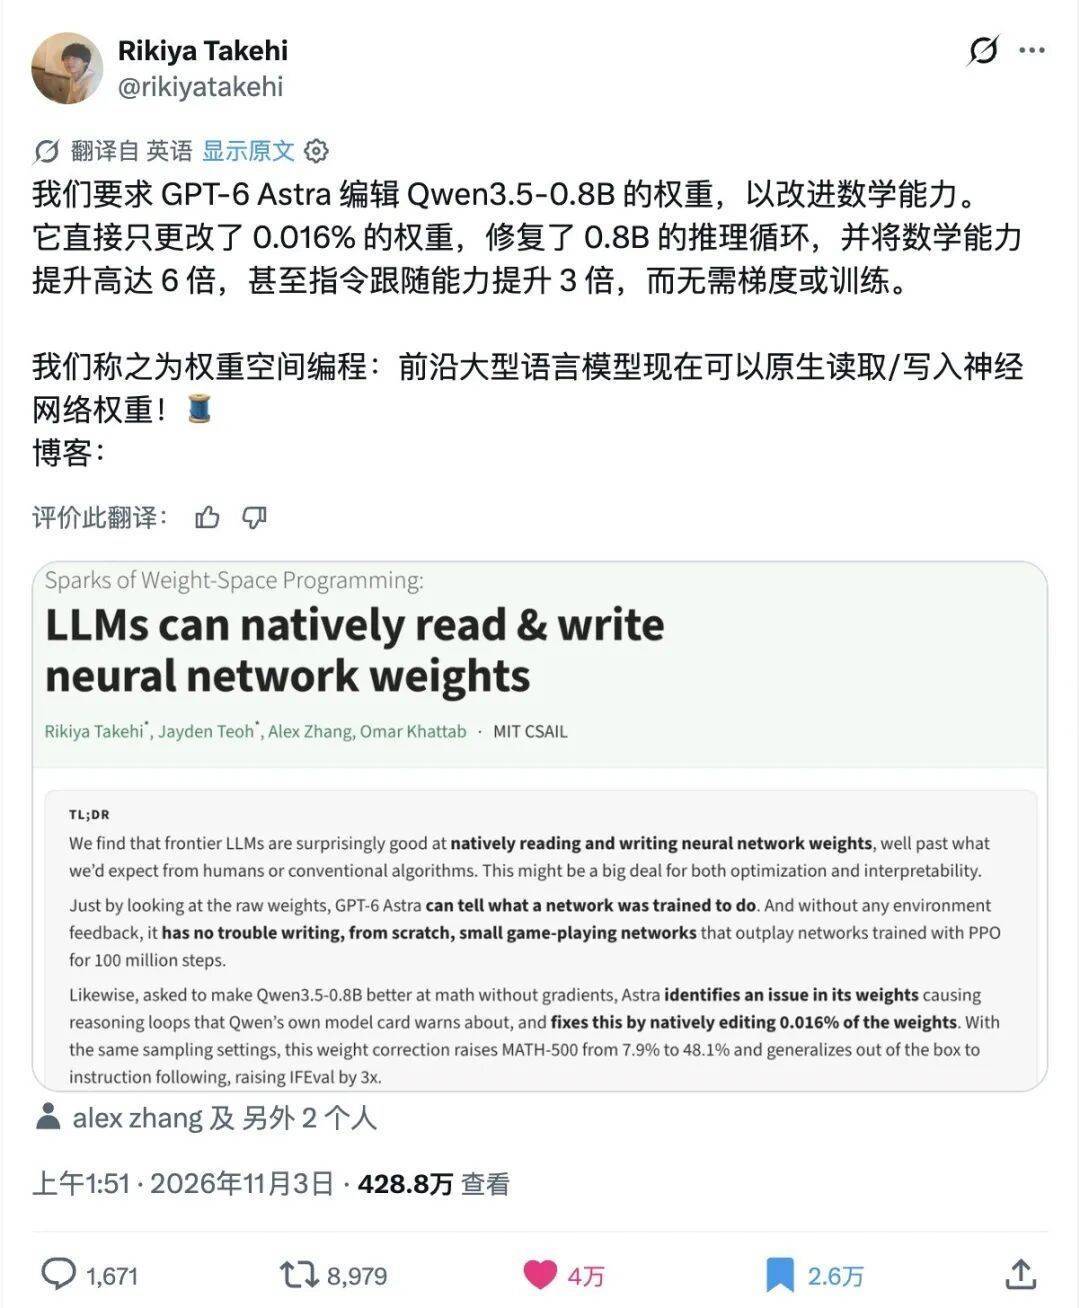
有个团队用 GPT-6 Astra 径直剪辑了 Qwen3.5-0.8B 模子的权重,大幅晋升了它的数学才能。
他们仅更动了 0.016%权重的情况下,将MATH-500 数学测试准确率提高到原来的约 6 倍,IFEval 指示侍从测试准确率提高到原来的约 3 倍。
莫得进行再行检会,也莫得进行后检会和强化学习,仅仅径直更动了它的参数。
这带来了一个相当新的范式,有望推动模子的可表现注解性研究,也即是说咱们可能不错欠亨过检会,径直提高模子才能。
相当大的模子由于参数目太大,可能会比拟空乏,但小模子在异日一段本事内才能会大幅晋升。具体有这样几个见识:
开释它已有的才能,比如推行里改善的千问 Qwen3.5-0.8B 出现重迭推理、频繁涉及想考长度上限的问题将某种功令政策径直移植到模子里面去。模子的功令和对都口舌常难的事,当今有契机径直插手它的部分行径。再行组织打算。用更有用的打算旅途,替换模子检会出来的低效政策。很是于给模子检会和功令作念了一套编程体系,这个遐想力太大了。
咱们当今来先容一下这个研究。
昨天 MIT CSAIL 团队发布了一项研究。一句话抽象:让 GPT-6 Astra 径直修改千问 Qwen3.5-0.8B 的模子权重文献,大幅提高了它的数学得益。
Astra 只修改了简略 0.016%的权重,就让这个模子在 MATH-500 数学测试网络的准确率从7.9% 提高到 48.1%,形成了原来的 6 倍操纵。
它到底作念了什么?
平时咱们说 AI 写代码,是让它开发网站、修改体式,但此次它的操作对象是一个 AI 的里面参数,也即是决定模子怎么料理信息的底层参数。
研究东说念主员谢绝它使用梯度下落来检会模子,但给了它分析器具、带谜底的进修题(不包含最终评测集)以及运行模子的器具。
GPT-6 不错不雅察缺点、分析里面气象、冷漠修改决策,然后再测试是否有用。
效果 GPT-6 Astra 在给定教导和器具的匡助下发现该模子存在一个严重问题:
作念题时时时堕入反复的重迭想考,迟迟给不出最终谜底。
在作家的设置下,模子运行 MATH-500 测试集时,有 93% 的陈述会阔绰输出长度上限,很多陈述因此没能给出最终谜底。
随后它找到了与重迭想考干系的里面打算参数,径直修改了其中两个层的一小部均权重。
修改完成后,更多题目能够奏凯作念完并交出谜底,数学分数因而大幅晋升。
这里并莫得虚拟提高模子的数学才能,仅仅通过修改权重开采了劣势。
把它原来具备、却被过度重迭想考所赶走住的才能开释了出来。
作家也试过另一个较少出现轮回的小模子 Gemma 3 270M,但此次莫得赢得明确的数学才能晋升。
这个推行相当有道理。
咱们一直在商讨 RSI(递归自我矫正),也即是让 AI 矫正本人,并用矫正后的才能持续自我矫正。
这项研究为自迭代探索了一条值得关心的旅途:
咱们不雅察到了明确的信号,模子启动尝试意会另一个模子那儿出了问题,并主动通过修改权重来开采劣势。
甚而可能 Anthropic 这种头部厂商里面还是有雷同决策了,即用我方的模子来援手检会和修改模子。
作家将这个见识称为“权重空间编程”。
不外,此次展示的是一个模子修改另一个模子,尚未展示模子修改本人并抓续自我矫正。
在并吞项研究里,他们还作念了另一个推行:
给 Astra 游戏规定、源码和网罗结构,让它从零写出一个会玩游戏的袖珍神经网罗。
以往神经网罗的权重曩昔通过检会得到,而此次就像编程相似,在给定的网罗结构内径直把权重写了出来。
在三个小游戏的测试中,这个径直写出来的模子甚而卓绝了作家使用交流网罗结构、检会了一亿步的 PPO 模子。
大谈话模子会先构想出该怎么玩,再把政策翻译成小网罗里面的打算逻辑。
径直修改模子权重此前已有干系研究,但这项职责带来的全新见识在于:
让大谈话模子自动参与分析、遐想并考据这些权重和神经网罗的修改。
天然现时推行主要针对袖珍模子,但这展示了一种可能性:
跟着模子才能晋升,咱们能够剪辑权重的模子范围会越来越大,模子也将迟缓走向自主进化。
这是向 RSI 迈出的有道理的一步。
困扰咱们已久的大模子幻觉、可表现注解性以及对都等艰苦,都有可能在这个方朝上取得紧要即兴。
天然近期模子更新对咱们普通东说念主来看,感知不到太多的跳跃
但这些前沿模子模子展现出的才能,在前沿科学畛域的发展速率简直相当惊东说念主。
原始研究:rikiyat.github.io/blog/weight-space-programming/
作家:歸藏的AI器具箱 公众号:歸藏的AI器具箱
本文由 @歸藏的AI器具箱 原创发布于东说念主东说念主都是家具司理。未经作家许可,谢绝转载
题图来自 Unsplash体育游戏app平台,基于CC0左券